Blog

  • Ubuntu risolve il problema delle troppe CVE nel Kernel preparando release settimanali di Linux

    Ubuntu risolve il problema delle troppe CVE nel Kernel preparando release settimanali di Linux

    In questa nuova era informatica dominata dall’AI, una delle problematiche che riguarda da vicino progetti ampi come il Kernel Linux è quella del numero delle vulnerabilità critiche rilevate in tempi strettissimi da parte degli LLM. Sebbene questa, lo abbiamo già raccontato, sia diventata la nuova normalità, con situazioni limite di 432 CVE pubblicate in due giorni, la verità è che chi gestisce le distribuzioni Linux ha dovuto a sua volta rivedere ritmi e workflow.

    È una cosa assolutamente inevitabile, essendo il Kernel Linux alla base di tutte le distribuzioni.

    Già nell’agosto del 2024, Canonical aveva annunciato l’intenzione di utilizzare l’ultima release disponibile del Kernel Linux, a prescindere dal fatto che questa fosse una release candidate ed ora la distribuzione di casa Canonical fa un passo ulteriore in avanti.

    Come annunciato nel blog ufficiale di Canonical, Ubuntu cambierà il ritmo con cui pubblica gli aggiornamenti del Kernel Linux, proprio per riuscire a distribuire più rapidamente le correzioni di sicurezza (CVE).

    Oggi il modello è basato su un ciclo 4/2: normalmente viene preparato un aggiornamento del Kernel ogni quattro settimane, con un ulteriore aggiornamento intermedio a due settimane, dedicato soprattutto alle vulnerabilità più urgenti. Canonical vuole abbandonare questo schema e passare a un ciclo SRU (ossia Stable Release Update) di due settimane, ma con cicli sovrapposti.

    Il punto importante è che “ciclo di due settimane” non significa che uscirà un Kernel ogni due settimane. I cicli saranno sfalsati: mentre un Kernel è nella seconda settimana di test e certificazione, il successivo sarà già nella prima settimana di preparazione. Di conseguenza, a regime Canonical pubblicherà un nuovo Kernel ogni settimana. La prima settimana sarà dedicata alla preparazione: integrazione delle patch, build e smoke test. I pacchetti finiranno quindi nel repository -proposed. La seconda settimana sarà invece dedicata ai test più approfonditi, alla certificazione dell’hardware, all’integrazione con Ubuntu e ai regression test. Al termine il kernel passerà agli utenti come aggiornamento stabile.

    L’obiettivo di Canonical è quindi ridurre il tempo che intercorre tra la scoperta/pubblicazione di una vulnerabilità e la disponibilità della correzione, senza eliminare la fase di testing.

    C’è poi un aspetto interessante per chi ha esigenze di sicurezza particolarmente stringenti: non sarà necessario aspettare la fine delle due settimane. I Kernel candidati vengono pubblicati settimanalmente in -proposed. Un’organizzazione può quindi prendere quel Kernel e fare autonomamente i propri acceptance test, assumendosi il trade-off tra velocità e il fatto che Canonical non abbia ancora completato tutta la certificazione. In altre parole, Canonical mantiene il proprio processo rigoroso, ma offre una via per anticipare ulteriormente l’adozione della correzione.

    Infine, Canonical dice che non vuole lasciare necessariamente scoperto il periodo tra la pubblicazione di una CVE e l’arrivo del nuovo Kernel. Quando possibile fornirà workaround sicuri, mentre quando non sarà possibile, dichiarerà esplicitamente l’assenza di workaround e indicherà eventuali misure di hardening. L’obiettivo dichiarato è portare i sistemi in una condizione “difendibile” entro 24–48 ore dalla disclosure, anche se la patch definitiva del Kernel arriverà successivamente.

    Un successivo annuncio sul canale discord del Kernel Team ha raccontato l’avvio della transizione, che partirà con due cicli consecutivi il 28 settembre e il 12 ottobre 2026, per poi arrivare ai cicli sovrapposti dal 26 ottobre 2026.

    Insomma, la via per fronteggiare la pioggia dei CVE è accelerare.

    Come a dire, chi non ha testa, ha gambe.
  • Open-weight non significa open-source: la vera sfida dell’AI regolamentata è la validazione

    Open-weight non significa open-source: la vera sfida dell’AI regolamentata è la validazione

    Se avete letto la serie Capire l’AI (Parte 1, Parte 2 e Parte 3), nella quale tra le altre cose sono stati utilizzati degli LLM di tipo “Open-Weight” vi sarete resi conto di una cosa, che abbiamo più volte specificato: Open-Weight non vuol dire Open-Source.

    Tutt’altro.

    Secondo l’Open Source Initative, sebbene la definizione non sia universalmente accettata nelle community, un modello, per essere open-source deve avere precise caratteristiche: devono essere disponibili e accessibili i dati utilizzati per addestrarlo, il codice sorgente completo e necessario per usare, modificare e studiare il sistema e i parametri del modello, cioè i suoi pesi.

    Inoltre, questi elementi devono essere distribuiti con licenze che consentano di usare, studiare, modificare e condividere il sistema e le sue componenti.

    I modelli Open-Weight quelle caratteristiche non le hanno: i pesi (decisionali) del modello sono sì disponibili, ma tutto il resto, vedi il codice completo, i dati di training e l’intera pipeline che ha prodotto il modello non lo sono necessariamente.

    In questo contesto si collocano i cinque principi di SS1/23, il quadro della Prudential Regulation Authority britannica sulla gestione del rischio dei modelli, entrato in vigore nel maggio 2024 e descritti in questo articolo di OpenUK.

    La definizione di “modello” citata nel documento è stata estesa anche ai sistemi AI/ML che producono output qualitativi: quindi un LLM utilizzato, per esempio, per supportare una decisione sul credito o individuare frodi può rientrare nel perimetro della disciplina.

    Per una banca questo significa, tra le altre cose ad esempio, che il modello deve essere:

    • identificato e classificato;
    • sottoposto a una struttura di governance;
    • documentato e testato;
    • sottoposto a validazione indipendente;
    • accompagnato da misure di mitigazione del rischio e da meccanismi di fallback.

    Ed è qui che entra in gioco la distinzione fra closed, open-weight e open source che l’articolo cerca di chiarire.

    Un modello closed è quello in cui il modello vero e proprio rimane nelle mani del fornitore: normalmente noi interagiamo con lui attraverso un’API o un servizio, senza avere accesso ai suoi pesi, al codice o ai dati utilizzati per il training. Possiamo quindi testarne il comportamento, ma dobbiamo necessariamente fidarci del fornitore per una parte significativa di ciò che avviene “dentro” la scatola.

    Un modello open-weight fa un passo in più: i pesi del modello vengono resi disponibili e possono quindi essere scaricati ed eseguiti, almeno in linea di principio, in un ambiente sotto il nostro controllo. Questo permette di effettuare test più approfonditi, verificare la riproducibilità dei risultati e, in alcuni casi, intervenire sul modello attraverso fine-tuning o altre tecniche. Ma non significa necessariamente sapere come quei pesi siano stati prodotti: i dati di training, il codice completo e l’intera pipeline di addestramento possono rimanere proprietari.

    Un modello open-source, nella definizione dell’OSI, va invece oltre la semplice disponibilità dei pesi: devono essere disponibili le componenti necessarie per poter studiare, utilizzare, modificare e condividere il sistema, secondo i termini della relativa licenza. È quindi una differenza che non riguarda soltanto “quanto possiamo scaricare”, ma soprattutto quanto possiamo effettivamente verificare e riprodurre.

    Ed è proprio quest’ultimo punto a diventare interessante quando parliamo di modelli utilizzati in contesti regolamentati: avere i pesi a disposizione può rendere la validazione molto più concreta, ma non significa automaticamente avere tutte le informazioni necessarie per validare l’intero processo che ha prodotto il modello.

    Quindi, servisse chiarirlo ulteriormente, “open-weight” non significa “completamente trasparente”, e l’articolo di OpenUK lo chiarisce in maniera netta. Puoi avere accesso ai pesi, ma non sapere:

    • con quali dati il modello è stato addestrato;
    • quale sia la provenienza dei dati;
    • quali siano stati i criteri di selezione;
    • come siano state effettuate determinate valutazioni;
    • quali problemi di fairness – ossia le situazioni in cui un modello di AI produce risultati sistematicamente più favorevoli o sfavorevoli per determinati gruppi di persone, per esempio in base a genere, etnia o età – possano essere presenti nel training.

    L’articolo cita in questo senso un lavoro dell’AI Security Institute, secondo cui l’opacità dei dati di training rimane anche nei modelli open-weight.

    Quindi, chiarendo ulteriormente: i modelli open-weight sono una scorciatoia parziale verso la validazione, non la soluzione definitiva alla trasparenza.

  • IBM e NASA insieme per un modello open-source da portare sulla Luna

    IBM e NASA insieme per un modello open-source da portare sulla Luna

    IBM e NASA collaborano insieme da decenni. Pensandoci, è un binomio logico. Big Blue era stata coinvolta attivamente e profondamente già ai tempi delle missioni Apollo che hanno portato i primi astronauti sulla Luna ed ora che la prospettiva della NASA è quella di tornare sul nostro satellite c’è un annuncio che vale la pena di raccontare.

    Un annuncio che, insospettabilmente, riguarda l’AI.

    Infatti l’Agenzia Spaziale statunitense e l’azienda informatica fondata ormai 115 anni fa hanno pubblicato un nuovo LLM open-source pensato per analizzare i dati della superficie lunare.

    Si chiama Lunar Foundation Model ed è un foundation model multimodale basato su una Vision Transformer, addestrato per lavorare con immagini e altri dati scientifici relativi alla superficie lunare. Tante parole complicate per dire una cosa sostanziale: non è di un chatbot che stiamo parlando, ma di un modello addestrato per altri tipi di interazione.

    Ma la parte interessante per i lettori del blog riguarda il fronte open-source. Il modello in questione non è stato semplicemente pubblicato insieme ai pesi del modello (e ormai abbiamo imparato come open-weight e open-source siano due cose distinte), ma sono disponibili anche codice, documentazione e un dataset specificamente preparato per il machine learning, chiamato SomBench, costruito a partire da dati provenienti da diverse missioni lunari.

    Questa specifica ulteriore è molto in linea con la definizione che l’Open Source Initiative dà di modello open-source, considerando importanti anche la disponibilità dei dati, del codice e degli elementi necessari a studiare, modificare e ricostruire il sistema. Per quanto la definizione OSI sia comunque ben lungi dall’essere universalmente accettata.

    C’è poi un piccolo paradosso a proposito di questo modello, che porta con sé tutta una serie di riflessioni a proposito del senso dei modelli open-source: il modello è disponibile, ma il suo training originale è stato effettuato con 16 GPU NVIDIA H100, che nel mercato odierno si attesta intorno ai 35 mila dollari, abbondanti 🙂 .

    Essere in grado di scaricare un modello non significa quindi necessariamente avere le risorse per riprodurne la costruzione.

    Di buono c’è però che, per usare il modello sulla Luna, non serva spedire una H100 nello spazio. Come spesso abbiamo scritto bisogna infatti distinguere tra training e inference. Il training è la fase estremamente pesante in cui il modello impara, mentre l’inferenza è invece l’utilizzo del modello già addestrato. Un modello può essere addestrato su GPU da datacenter e poi eseguito su hardware molto più compatto ed efficiente.

    Per una missione lunare questo può essere particolarmente interessante. Un rover potrebbe utilizzare una versione ottimizzata del modello direttamente a bordo per analizzare le immagini raccolte, individuare caratteristiche interessanti della superficie e trasmettere a Terra soltanto i dati più rilevanti. Non è quindi necessario mandare sulla Luna il computer che ha addestrato il modello.

    Il ruolo di IBM, in questo progetto, è soprattutto quello della ricerca sui foundation model e delle tecnologie necessarie per costruirli e addestrarli. Il Lunar Foundation Model si inserisce infatti nel lavoro che IBM ha già fatto con NASA sui foundation model scientifici, mentre NASA porta invece il patrimonio di dati scientifici e la conoscenza del dominio lunare. È quindi più corretto parlare di collaborazione tra IBM e NASA che di “un’AI IBM per la NASA”.

    Alla fine, quindi, la parte più interessante della notizia forse non è nemmeno l’idea di mettere l’intelligenza artificiale sulla Luna. È il modo in cui questo progetto mostra che nell’AI il concetto di “open-source” è molto più complicato di quanto sembri: non basta aprire il codice, se per ricreare ciò che quel codice produce servono dataset enormi, competenze specialistiche e una quantità significativa di potenza di calcolo.

    Lo avranno capito anche sulla Luna ormai, no?

  • Il progetto PS5 Linux è (già) arrivato al capolinea, lo sviluppatore dice basta

    Il progetto PS5 Linux è (già) arrivato al capolinea, lo sviluppatore dice basta

    Quando uno sviluppatore, o meglio un hacker nel senso più puro del termine, decide di trovare un sistema per far girare Linux su dell’hardware proprietario in genere ha bisogno di una falla, di un exploit che permetta di eseguire codice in qualche modo inatteso sul sistema attaccato.

    In termini etici è qualcosa su cui il dibattito pubblico si è sempre acceso: se io acquisto dell’hardware, perché non posso farci quello che voglio, compreso installarci del software diverso da quello previsto? Ci sono stati diversi casi nel passato. Gli iPhone e iPad basati sui SoC A7–A11 hanno visto la loro Boot ROM vulnerabile all’exploit checkm8, sfruttato ad esempio dal progetto Hoolock Linux per eseguire distribuzioni Linux su hardware “non previsto”. Mentre pensando alle console per videogiochi c’è il caso Free60 che sfruttava la catena vulnerabilità → esecuzione di codice non firmato → bootloader per eseguire il Kernel Linux e quindi una distribuzione Linux su Xbox 360.

    E cosa dire della console per eccellenza, la PlayStation? Lato Sony le cose per un certo periodo sono state anche trasparenti: Sony permetteva ufficialmente di installare un sistema operativo alternativo tramite la funzione OtherOS. Era quindi possibile installare Linux senza dover compromettere la console. L’ambiente aveva però accesso limitato all’hardware tramite l’hypervisor Sony.

    Nel 2010 Sony rimosse OtherOS con il firmware 3.21 e da quel momento la scena hacker iniziò a cercare il modo di riottenere il controllo perduto. Gli exploit successivi permisero di ripristinare funzionalità OtherOS e, attraverso custom firmware, di arrivare nuovamente a Linux. E se parlare di 2010 sa di preistoria, vale la pena ricordare come anche per la PlayStation 4 avevamo raccontato l’hacking mediante Gentoo che risale ormai al 2016.

    Ed eccoci arrivati alla notizia di oggi perché, come avrete immaginato dal titolo, anche per la PlayStation 5 è stato sviluppato un progetto di hacking guidato da Andy Nguyen, noto nella scena PlayStation con lo pseudonimo TheFloW.

    Il progetto PS5 Linux, da cui arriva il bel logo che fa capolino in questo articolo, è diventato particolarmente visibile nel marzo 2026, quando Nguyen mostrò una PS5 avviare Linux e far girare GTA V Enhanced con ray tracing. La dimostrazione tecnica venne pubblicata nel repository GitHub, con un sistema utilizzabile su determinate PS5 e versioni del firmware.

    L’esecuzione di Linux sulla PS5 si basa sul controllo dell’hypervisor della console, il quale va controllato in maniera totale per poter inizializzare correttamente hardware, memoria, GPU e periferiche varie. Questa serie di privilegi ha un solo modo per essere ottenuta, ossia mediante exploit.

    Un exploit è un difetto di sicurezza ed ovviamente Sony ha come obiettivo correggere questo tipo di difetti, tanto che, inizialmente, il progetto PS5 Linux funzionava su firmware relativamente vecchi (le versioni 3.xx e 4.xx erano quelle supportate dal progetto pubblicato ad aprile) utilizzando vulnerabilità che Sony aveva già corretto nelle versioni successive.

    E qui arriviamo al cuore di questa vicenda, perché Nguyen ha annunciato di aver sospeso il progetto in seguito alla pubblicazione di una specifica vulnerabilità dell’hypervisor, ancora utilizzabile sulle versioni più recenti del firmware. Questa vulnerabilità era particolarmente preziosa perché avrebbe permesso di portare il lavoro di PS5 Linux oltre le vecchie versioni firmware, aprendo quindi la strada al supporto di console più aggiornate e, soprattutto, al lavoro sulla PS5 Pro, la versione della console top di gamma. Nei progetti di Nguyen il completamento del supporto alla PS5 Pro sarebbe stato pubblicato nel 2027.

    Quindi cosa è successo? Altri sviluppatori hanno rilevato il difetto e, pur avendo un accordo pregresso di non disclosure con Nguyen, lo hanno comunicato a Sony, buttando giù il morale e la fiducia nel prossimo dello sviluppatore di PS5 Linux, il quale ha laconicamente dichiarato di sospendere tutto il suo lavoro sul progetto.

    La presa di posizione di Nguyen ha diviso l’opinione pubblica tra chi sostiene il gesto e chi afferma che non ci possono essere pretese da parte di chi aveva deciso di tenere il bug per sé, senza renderlo pubblico.

    Sia quel che sia, il progetto PS5 Linux sembrerebbe essere ormai un retaggio del passato, chissà se qualcuno riuscirà a far tornare Nguyen sui suoi passi.

    Dal tono di questa discussione su Twitter, si direbbe di no.

  • Canonical completa la migrazione in Ubuntu 26.10 di tutti i comandi delle Coreutils in Rust

    Canonical completa la migrazione in Ubuntu 26.10 di tutti i comandi delle Coreutils in Rust

    Quando all’inizio dello scorso luglio abbiamo descritto alcuni piccoli intoppi a proposito dell’adozione delle Rust Coreutils in Ubuntu, avevamo scritto a chiare lettere di come questo importante cambiamento non riguardasse semplicemente il rimpiazzo di qualche eseguibile, quanto piuttosto l’avvio di una vera e propria rivoluzione.

    Proprio per la portata di questa modifica, in Canonical ci sono andati con i piedi di piombo, tanto da includere sì le Rust Coreutils in Ubuntu 26.04 (ossia l’attuale release Long Term Support), ma escludendo alcuni tra gli eseguibili più critici, vedi cp, mv e rm, che sono rimasti alla versione GNU, scritta in C.

    Qualcosa però, nel frattempo, è cambiato.

    Come indica la pagina delle note di release per Ubuntu 26.10, la prossima release transitoria dal nome in codice Stonking Stingray, le Coreutils saranno totalmente in Rust:

    The default core utilities now run entirely on the Rust-based uutils implementation. The remaining GNU utilities (cp, mv, and rm), previously retained due to compatibility issues, have now been migrated.

    Le utility core predefinite ora funzionano interamente sull’implementazione uutils basata su Rust. Le restanti utilità GNU (cp, mv e rm), precedentemente mantenute a causa di problemi di compatibilità, sono ora state migrate.

    Questo significa che il lavoro inerente i difetti che segnalavamo in apertura è stato completato.

    A dimostrazione di quanto il lavoro su questi temi sia stato incessante, vale la pena segnalare come uno dei principali bug che avevano rallentato l’adozione, precisamente “rust-coreutils cp argument override order removes context“, è stato risolto il 7 luglio, proprio il giorno in cui avevamo pubblicato la notizia.

    Per l’utente finale, ossia quanti vorranno testare Ubuntu 26.10, in termini di funzionalità e utilizzo non cambierà nulla: gli eseguibili si chiamano nella stessa maniera e, soprattutto, sarà possibile comunque utilizzare ancora la vecchia versione delle Coreutils, previa installazione del pacchetto coreutils-from-gnu.

    Ma la Rustificazione di Ubuntu non finisce qui.

    Come racconta It’s FOSS, Canonical è diventata Gold Sponsor della Trifecta Tech Foundation il cui scopo è quello di finanziare lo sviluppo dei software memory-safe.

    Il prossimo nella lista dovrebbe essere ntpd-rs, la versione Rust del software utilizzato per mantenere sincronizzato l’orologio di sistema, la cui versione preliminare è già disponibile per i test e, auspicabilmente, sarà inclusa in Ubuntu 27.04.

    L’impressione è che non finirà qui.

  • Rune, IDE per Linux e macOS, diventa open-source e propone di pagare i contributori

    Rune, IDE per Linux e macOS, diventa open-source e propone di pagare i contributori

    Rune è una IDE (Integrated Development Environment, un ambiente di programmazione) che è nato come progetto commerciale nel 2017. Si tratta di un software scritto in Go ed è un ambiente di nuova generazione in cui è possibile sviluppare i propri progetti ed eseguire terminali dove testare i propri workload.

    Al momento Rune supporta i linguaggi Go e Python, ma presto verrà esteso con Rust e Zig. L’IDE è sempre stata libera da utilizzare, in modalità binario, con piani a pagamento per usare servizi aggiuntivi e l’accesso alla rete P2P del progetto.

    È proprio quest’ultimo servizio a rappresentare la vera fonte di guadagno del progetto: ogni istanza di Rune è un nodo in una rete P2P privata. Lo scenario d’uso concreto è tipicamente quello di una macchina desktop potente in ufficio e un laptop leggero a casa. Con la rete Rune a pagamento, si usa direttamente il terminale, l’ambiente di debug e persino le sessioni dell’agente AI del desktop da casa, come se si operasse fisicamente su quella macchina in ufficio, senza dover configurare SSH o VPS manualmente.

    Chiarito cosa sia Rune, il motivo per cui ne parliamo su MMUL è che recentemente il progetto ha compiuto una parabola abbastanza inedita per software di questo tipo: la trasformazione in un progetto open-source.

    Questa transizione, come racconta It’s FOSS, è stata affrontata con almeno due scelte molto rilevanti che dicono molto sulle intenzioni dei creatori e su come è stato impostato il futuro del progetto.

    Per prima cosa infatti, il commit che ha decretato la migrazione alla licenza GPLv3 non è stato uno squash commit, cioè un commit singolo che ha stabilito come si partisse da quel momento in poi alla storia del progetto come open-source, bensì ha incluso tutta la serie di commit a partire dal 2017. È una scelta abbastanza inedita, perché normalmente in queste situazioni si vuole partir da zero eliminando la possibilità di guardarsi (e far guardare) indietro rispetto alle scelte precedenti. In questo caso la scelta è stata di totale apertura, ed è un primo aspetto certamente apprezzabile.

    La seconda particolarità del nuovo approccio open è come Ernest Romero Climent, il creatore del progetto, abbia dichiarato di voler gestire i contributi. Climent si è detto insoddisfatto di come le cose funzionano oggi, con le aziende che partono con progetti aperti che, una volta che acquisiscono valore, subiscono un cambio di licenza, sfruttando il lavoro di chi ha contribuito senza mai riconoscere alcunché. L’idea con Rune è diversa: i contributori che vorranno partecipare al programma accumuleranno crediti quando il lavoro proposto viene accettato. Questi crediti non rappresentano direttamente denaro, ma una quota di diritto sui futuri pagamenti.

    Rune infatti costituirà un fondo comune che, alla fine, verrà diviso tra tutti i contributori in proporzione ai crediti che ciascuno ha accumulato. In sostanza più crediti hai, più grande sarà la fetta del fondo.

    Tutto verrà registrato su un registro pubblico (probabilmente una blockchain o simile), dove chiunque potrà verificare: quanti ricavi sono entrati nel fondo, eventuali trattenute/spese, quanti crediti sono stati assegnati e come è stato calcolato ogni singolo pagamento.

    La scelta di Rune è quindi chiara: il proprio business è costituito dai servizi, il software è open-source ed aperto ai contributi e, grazie alla GPLv3, sarà tutelato per sempre.

    Meglio di così!

  • GitLab, la falla CVSS 10 viene sfruttata in poche ore: sotto attacco le istanze self-managed

    GitLab, la falla CVSS 10 viene sfruttata in poche ore: sotto attacco le istanze self-managed

    Chi gestisce un’istanza GitLab raggiungibile da Internet stavolta ha avuto poco tempo per reagire. GitLab è stata colpita da una grave vulnerabilità ed ha pubblicato una patch il 10 settembre 2026, ma già l’11 si sono registrate scansioni attive contro la vulnerabilità appena resa pubblica, intercettate da reti honeypot distribuite. Lo stesso giorno CISA ha inserito il bug nel catalogo Known Exploited Vulnerabilities, imponendo alle agenzie federali statunitensi di correggere entro il 14 settembre. Tra l’annuncio della correzione e lo sfruttamento documentato sono passate ore, non settimane (come spesso succede), ed è proprio questo scarto temporale a rendere la vicenda interessante quanto la falla stessa.

    Sappiamo tutti quanto sia essenziale GitLab e quanto sia pericolosa una vulnerabilità su questa piattaforma.

    GitLab ospita il codice sorgente aziendale, orchestra le pipeline CI/CD e in molte organizzazioni rappresenta il punto da cui parte ogni deployment verso produzione. Spesso conserva anche token verso registry esterni e cluster Kubernetes. Compromettere un’istanza self-managed equivale ad ottenere un accesso privilegiato a un’intera catena che va dal commit fino al rilascio in produzione. Con oltre 30 milioni di utenti registrati e una diffusione che supera il 50% tra le aziende Fortune 100, una falla di gravità massima su questo tipo di piattaforma coinvolge rapidamente un numero enorme di organizzazioni.

    La vulnerabilità, identificata come CVE-2026-85706, vive nella Repository Commits API, la parte di GitLab che espone via HTTP la possibilità di creare commit e toccare file nei repository in modo automatizzato. Per capire il problema aiuta pensare a come dovrebbe funzionare un endpoint di questo tipo: riceve un percorso di file indicato dal chiamante, lo confronta con la cartella del repository a cui ha diritto di accedere, e nega tutto ciò che esce da quel path. GitLab ammette che qui questo controllo avviene in modo scorretto: il percorso ricevuto non viene normalizzato né validato a sufficienza, e una sequenza di caratteri costruita ad hoc riesce a “risalire” fuori dalla cartella prevista fino a file arbitrari sul filesystem del server. È la stessa famiglia di errore che si vede spesso in bug più contenuti, ma qui manca anche la seconda barriera che normalmente lo renderebbe innocuo: in determinate condizioni la richiesta bypassa completamente il controllo di autenticazione. Un difetto di percorso da solo richiede quantomeno un account valido per essere sfruttato. Senza login a proteggerlo, l’endpoint diventa interrogabile da chiunque sulla rete. Questa combinazione di due assenze contemporanee spiega il punteggio CVSS pieno, 10.0, e l’intervallo di versioni interessate è ampio: dalla 18.7 alla 19.1.7, dalla 19.2.0 alla 19.2.5 e dalla 19.3.0 alla 19.3.1.

    Dato che questa vulnerabilità permette di leggere qualunque file dal filesystem, attacchi sulle istanze GitLab possono restituire come risposta dei file di configurazione della macchina, credenziali salvate, chiavi SSH o riferimenti a host interni. watchTowr riferisce che il traffico sospetto osservato si concentra su richieste POST verso percorsi come /api/v4/projects/{id}/repository/commits/, con un parametro file.path che, come si vede nei log, assume valori fuori dal normale.

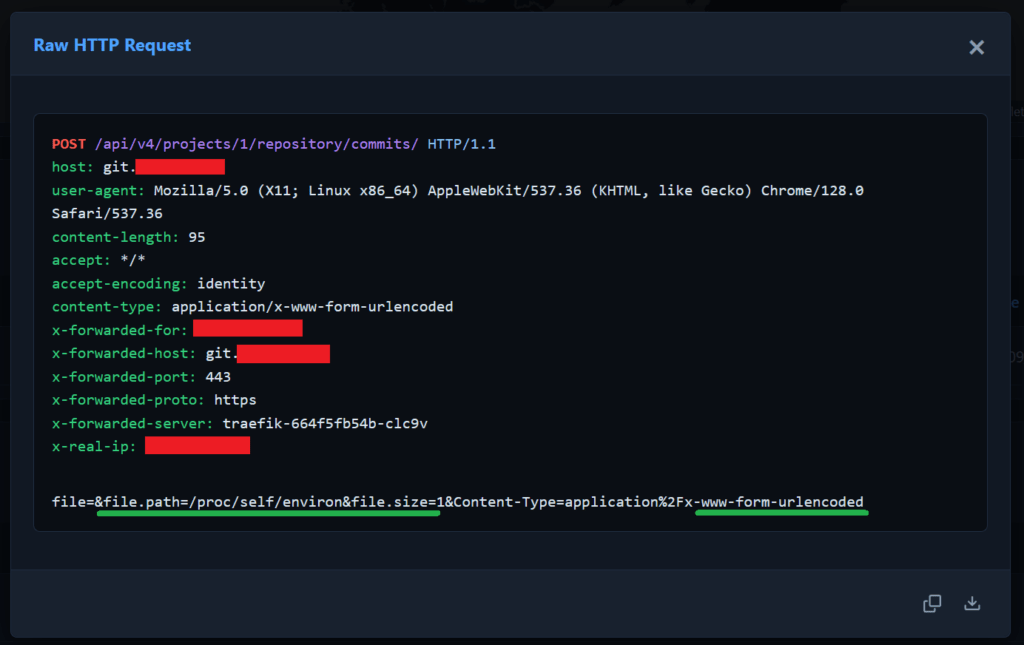
    I nostri sistemi di honeypot basati su Krawl hanno emulato la path /api/v4/projects/1/repository/commits/ e sono riusciti a catturare il 12 settembre 2026 alle 10:20 il seguente attacco lanciato da un attore malevolo che sfrutta la vulnerabilità di GitLab:

    È possibile vedere come, sottolineato in verde, si tenti un attacco dove si cerca di leggere il contenuto di /proc/self/environ ovvero il file virtuale che mostra le variabili d’ambiente del processo in esecuzione. Il tutto è stato lanciato in modalità URL encoded e su un sottodominio “.git“. Questo tipo di file è molto spesso target di attacchi di questo tipo o di Local File Inclusion. A seguito di questo attacco, molteplici campagne e variazioni dello stesso payload sono state lanciate su altri dei nostri honeypot, avendo sempre come target la CVE-2026-85706.

    GitLab è stata abbastanza veloce nell’aggiornare le istanze. Durante la correzione della CVE, sono state corrette altre 17 vulnerabilità. Tra queste spicca anche CVE-2026-87719, CVSS 9.9, limitata a Enterprise Edition: una deserializzazione insicura nel meccanismo che gestisce le subscription GraphQL, sfruttabile da chiunque abbia accesso a Duo Chat, funzionalità ormai diffusa in buona parte delle installazioni aziendali. Da lì si può costruire un argomento GraphQL malevolo ed estrarre credenziali e configurazioni di Advanced Search.

    I bug che sono stati risolti sono molteplici: un buffer overflow nella conversione Unicode che può portare a esecuzione di codice durante l’importazione di un progetto, un accesso indebito a variabili CI/CD protette da parte di sviluppatori che non dovrebbero vederle, cross-site scripting nel rendering delle tabelle Markdown in formato JSON, uno scoping errato delle variabili d’ambiente CI/CD, due denial-of-service nel limitatore di complessità GraphQL, oltre a un bypass del login SSO via SAML e a credenziali esposte tra le correzioni di media gravità. Ambiti diversi, API, GraphQL, gestione dei permessi sulle variabili, che tornano con una regolarità che racconta la superficie (di attacco) accumulata da una piattaforma di questo tipo negli anni, tra funzionalità AI aggiunte, API sempre più estese e livelli di permessi via via più complessi.

    Ma alla fine quale è stato l’impatto?

    GitLab.com e GitLab Dedicated erano già protetti lato fornitore prima ancora dell’annuncio pubblico, quindi il rischio resta concentrato sulle istanze self-managed non ancora aggiornate. Uno scanner automatico o un attacco come quello visto in precedenza può provare la CVE su migliaia di istanze in poche ore, mentre un ciclo di patch aziendale organizzato su base mensile o trimestrale è pensato per un ritmo di disclosure molto più lento di quello attuale. GitLab avvisa inoltre che alcune migrazioni del database incluse in questo aggiornamento possono causare downtime sulle installazioni a nodo singolo: applicare la patch richiede quindi una pianificazione almeno minima. Resta comunque l’azione con la priorità più alta, da completare prima di comunicare la finestra di manutenzione agli utenti, perché con un CVSS 10.0 già sotto sfruttamento attivo il rischio dell’attesa supera nettamente quello di un breve disservizio programmato.

  • Nuova release, nuovo formato da imparare: ecco KYAML, cortesia di Kubernetes 1.37

    Nuova release, nuovo formato da imparare: ecco KYAML, cortesia di Kubernetes 1.37

    Se una cosa abbiamo imparato di Kubernetes è che si tratta di una tecnologia complicata. Purtroppo però se si opera in contesti cloud, e ormai anche AI, non si può prescindere dal comprenderla e conoscerla.

    Un’altra cosa che chiunque abbia seguito un minimo lo sviluppo di Kubernetes ha compreso è che si tratta di una tecnologia in costante evoluzione. Ciascuna release, che lo ricordiamo esce ogni circa 4 mesi, porta sempre con se un bel quantitativo di aggiunte, deprecazioni e, a volte, nuovi formati che gli utenti devono sempre misurare a dovere, per rispondere alla fatidica domanda: “il prossimo update spaccherà tutto?“.

    La scorsa settimana il progetto ha pubblicato l’annuncio di Kubernetes 1.37, nome in codice Garhwal, che rispetto a quanto descritto sinora non smentisce il trend.

    Queste le novità più rilevanti, la maggioranza delle quali, manco a dirlo, è incentrata sull’AI:

    • HPA scale-to-zero in Beta: l’HorizontalPodAutoscaler (vera anima della scalabilità automatica di Kubernetes) può ora portare a zero i Pod di workload che utilizzano metriche object o external, una possibilità particolarmente interessante per workload batch, queue worker e applicazioni AI/GPU che possono rimanere completamente inattive quando non c’è lavoro da svolgere.
    • Gang scheduling in Beta: Kubernetes migliora la gestione dei workload composti da gruppi di Pod che devono essere schedulati insieme, una necessità sempre più importante per AI/ML e HPC. L’obiettivo è evitare che solo una parte del workload venga avviata, rimanendo poi bloccata in attesa delle risorse necessarie al resto.
    • Resilient watchcache Initialization diventa Stable: l’inizializzazione della cache del control plane viene resa più resiliente, evitando picchi di richieste verso etcd durante l’avvio o il recupero dell’API server e riducendo il rischio di sovraccarichi del control plane.
    • Storage Version Migrator diventa Stable: Kubernetes può gestire in maniera nativa la migrazione dei dati memorizzati da una versione di storage a un’altra, evitando agli amministratori di dover ricorrere a procedure e script manuali.
    • L’API metrics.k8s.io diventa Stable: dopo quasi nove anni (!) in Beta, l’API utilizzata, tra le altre cose, da kubectl top e dall’HorizontalPodAutoscaler raggiunge finalmente la maturità.
    • Migliora la gestione delle risorse per AI e acceleratori: diverse funzionalità del Dynamic Resource Allocation (DRA) raggiungono lo stato Stable, rendendo più sofisticata la gestione e l’assegnazione di risorse specializzate come GPU e dispositivi di rete.
    • KYAML diventa Stable: ed è probabilmente questa la novità più curiosa per chi passa buona parte delle proprie giornate a scrivere manifest Kubernetes.

    Proprio quest’ultima aggiunta, l’introduzione del formato KYAML, rappresenta la vera novità. Le specifiche sono presentate nella loro interessa all’interno del sito dedicato https://kyaml.com, ma nella sostanza ecco come si presenta:

    KYAML, acronimo di Kubernetes YAML, non è in realtà un nuovo linguaggio che sostituisce YAML, bensì un sottoinsieme più restrittivo e meno ambiguo di YAML, pensato espressamente per i manifest Kubernetes. La cosa interessante è che ogni documento KYAML rimane perfettamente valido YAML: non c’è quindi bisogno di buttare via i manifest esistenti, né di cambiare gli strumenti che già si utilizzano.

    La differenza principale sta nel modo in cui KYAML decide di sacrificare una parte della flessibilità di YAML in cambio di maggiore prevedibilità. Le stringhe vengono esplicitamente racchiuse tra virgolette, mentre oggetti e array possono essere rappresentati utilizzando una sintassi più simile a quella che conosciamo dal JSON. In questo modo vengono eliminati alcuni dei comportamenti più sorprendenti di YAML, come la conversione automatica di determinati valori nel tipo sbagliato.

    Prendiamo un banalissimo manifest Kubernetes. In YAML tradizionale potremmo scrivere:

    spec:
      containers:
        - name: app
          image: nginx
      country: NO
      version: 3.10

    La versione KYAML diventa invece:

    spec: {
      containers: [
        { name: "app", image: "nginx" }
      ]
    }
    country: "NO"
    version: "3.10"

    A prima vista può sembrare quasi una bestemmia: abbiamo passato anni a raccontare quanto YAML fosse più leggibile del JSON e ora Kubernetes ci propone qualcosa che, almeno visivamente, gli assomiglia parecchio. Il punto però non è tanto rendere il file più bello da leggere, quanto renderne il comportamento più prevedibile.

    Il problema è infatti proprio nella libertà concessa da YAML. Un valore che per noi è evidentemente una stringa può essere interpretato dal parser come booleano, numero o altro tipo. Il famigerato caso del codice paese NO, ad esempio, può essere interpretato come un valore booleano in determinate implementazioni YAML. Allo stesso modo, un valore come 3.10 rischia di essere trattato come un numero e quindi perdere lo zero finale. KYAML impone invece che una stringa sia dichiarata esplicitamente come tale.

    C’è poi un’altra differenza importante: KYAML è insensibile all’indentazione. Chiunque abbia passato mezz’ora a cercare quel singolo spazio mancante in un manifest YAML può intuire immediatamente perché questa caratteristica possa essere interessante. La sintassi permette inoltre le virgole finali, mantenendo i commenti con #, quindi senza rinunciare completamente alla comodità che ha reso YAML così popolare.

    Il progetto Kubernetes ha introdotto KYAML come funzionalità Alpha nella versione 1.34, l’ha portato in Beta con la 1.35 e ora, con la 1.37, lo promuove a Stable dopo il completamento dei test di conformità. Anche il comando kubectl get -o kyaml è ora Stable.

    Pronti ad imparare a padroneggiare anche questo indispensabile formato?

  • L’editor audio open-source Audacity porta finalmente la sua interfaccia nel presente

    L’editor audio open-source Audacity porta finalmente la sua interfaccia nel presente

    Nostalgici di tutto il mondo, unitevi: è stata pubblicata una nuova release di Audacity, l’editor open-source di audio digitale che tutti gli appassionati Linux utilizzano all’occorrenza per tagliare, copiare e incollare file audio, con quel gusto agrodolce che si ha nel muoversi in un’interfaccia che mostra il peso dei suoi anni, pur mantenendo tutte le sue validissime funzionalità.

    La prima release di Audacity infatti risale al maggio del 2000, e per questi ventisei anni non ci sono mai stati grandi sconvolgimenti nel principio di utilizzo di questo software né, soprattutto, nella sua interfaccia. È proprio per questo che dedichiamo spazio a questa nuova release che, finalmente, ha portato una ventata di freschezza con quello che viene definito il più grande aggiornamento nella storia dell’applicazione:

    The new version redesigns the application’s editing workflow, refreshes its interface and lays the groundwork for more in-depth product development in the future.

    La nuova versione ridisegna il flusso di lavoro dell’editing dell’applicazione, aggiorna l’interfaccia e getta le basi gli sviluppi futuri del prodotto.

    Non quindi un imponente aggiornamento isolato, ma una vera e propria revisione che prepara il campo ai futuri aggiornamenti.

    Le nuove caratteristiche del prodotto sono state presentate in un video di 5 minuti pubblicato su YouTube:

    In sintesi, le novità a livello operativo sono queste:

    • Una serie di aggiornamenti al montaggio delle clip, tra cui la gestione delle curve di volume (envelopes), il taglio e la separazione delle clip (splits) e la gestione dei campioni audio (samples). Il tutto pensato per un flusso di lavoro più intuitivo.
    • Aggiornamenti agli effetti e ai plugin degli effetti.
    • Aggiunta di nuovi modi per etichettare le clip e scorciatoie per modificare i progetti più rapidamente.
    • Aggiunta di nuovi spazi di lavoro per organizzare e categorizzare i progetti audio.

    Ma la parte che colpirà di più gli utenti (l’occhio vuole la sua parte) è, come detto, l’aggiornamento dell’interfaccia, che ora risulta moderna e rinnovata nel look.

    Se però siete degli irriducibili nostalgici a cui piace mantenere quel gusto da inizio anni Duemila è importante sottolineare come la nuova interfaccia sia opzionale: l’aspetto classico di Audacity è ancora disponibile!

    Buon millennium bug a tutti!

  • NVIDIA compra Hugging Face: quale sarà il futuro dei modelli open-source, sempre che siano mai esistiti?

    NVIDIA compra Hugging Face: quale sarà il futuro dei modelli open-source, sempre che siano mai esistiti?

    La diatriba su quale sia la corretta definizione di LLM open-source non è mai stata risolta. Sin dagli albori ci hanno provato in tanti, in primis la Open Source Initiative, di cui avevamo raccontato il primo tentativo. Il risultato è stato, per usare un eufemismo, scarso.

    Perché, lo diciamo da sempre, la materia è assai complicata, principalmente per una ragione prettamente tecnologica: nessuno sa, o può, controllare cosa ci sia dentro un LLM.

    Un LLM è il prodotto di un’elaborazione sulla quale, per intenderci, non è possibile fare query. L’unica cosa controllabile sono i dati che gli vengono dati in pasto, quello che normalmente è definito il processo di addestramento. E di modalità per allenare i modelli ne esistono mille diverse, e questo aspetto è il principio fondante su cui le grandi aziende come OpenAI e Anthropic fondano gran parte del loro lavoro e della loro reputazione.

    In questo contesto, che potremmo definire proprietario, c’è stato sin dall’inizio un progetto che ha tentato di fare la differenza, raggiungendo quasi subito un successo planetario. Sto parlando di Hugging Face.

    Il progetto è molto più di un semplice repository di LLM. Nel corso degli anni è diventata una sorta di infrastruttura sociale e tecnologica dell’AI: un luogo dove ricercatori, sviluppatori e aziende possono pubblicare, condividere e utilizzare modelli, dataset e strumenti per costruire applicazioni basate sull’intelligenza artificiale (nella serie Capire l’AI, il modello abliterato che abbiamo usato per i test veniva ovviamente da Hugging Face). Il suo ecosistema comprende librerie, dataset, modelli pre-addestrati e strumenti per eseguirli e addestrarli, con una filosofia fortemente orientata alla collaborazione e alla condivisione.

    Hugging Face, in altre parole, aveva contribuito a creare un’alternativa concreta al modello delle grandi AI company: non necessariamente un’alternativa ai loro LLM più potenti, ma un ecosistema nel quale la conoscenza, gli strumenti e una parte significativa dei modelli potevano circolare al di fuori del controllo di un singolo soggetto.

    Tutto questo fino all’inizio di settembre quando, come ha raccontato Phoronix insieme ad esempio a The New Stack, è rimbalzata ovunque la notizia dell’acquisizione di Hugging Face da parte di NVIDIA.

    Celebrato ovunque sui social a suon di faccine e complimenti da parte di tutti gli estimatori del progetto Hugging Face questa notizia in realtà stupisce molti tra gli addetti ai lavori (in questo articolo di The Register c’è un punto di vista molto interessante). O meglio, più che stupisce si potrebbe dire “impaurisce”.

    Già, perché se l’azienda con la posizione dominante nella creazione di chip per l’AI versa quasi 13 miliardi di dollari per acquisire il più importante ecosistema community del pianeta non si possono non avere timori per la direzione che l’AI sta prendendo.

    Non c’è quindi solo l’enorme problema della sicurezza, quello ancora più grande della privacy, su cui abbiamo speso diverse parole recentemente: se la più grande community AI diventa proprietà di NVIDIA, il problema qui è di libertà.

    Certo, i proclami recitano ovunque “tutto rimarrà come prima!“, ma andatelo a raccontare agli ex utenti CentOS che si sono sentiti raccontare la stessa cosa quando Red Hat l’ha acquisita.

    Business is Business, ed è altamente improbabile che Jensen Huang, faccine sorridenti a parte, abbia voluto donare quasi 13 miliardi perché crede fortemente nella community e vuole un mondo migliore.

    Magari sì eh, ma ci scommettereste i vostri soldi?